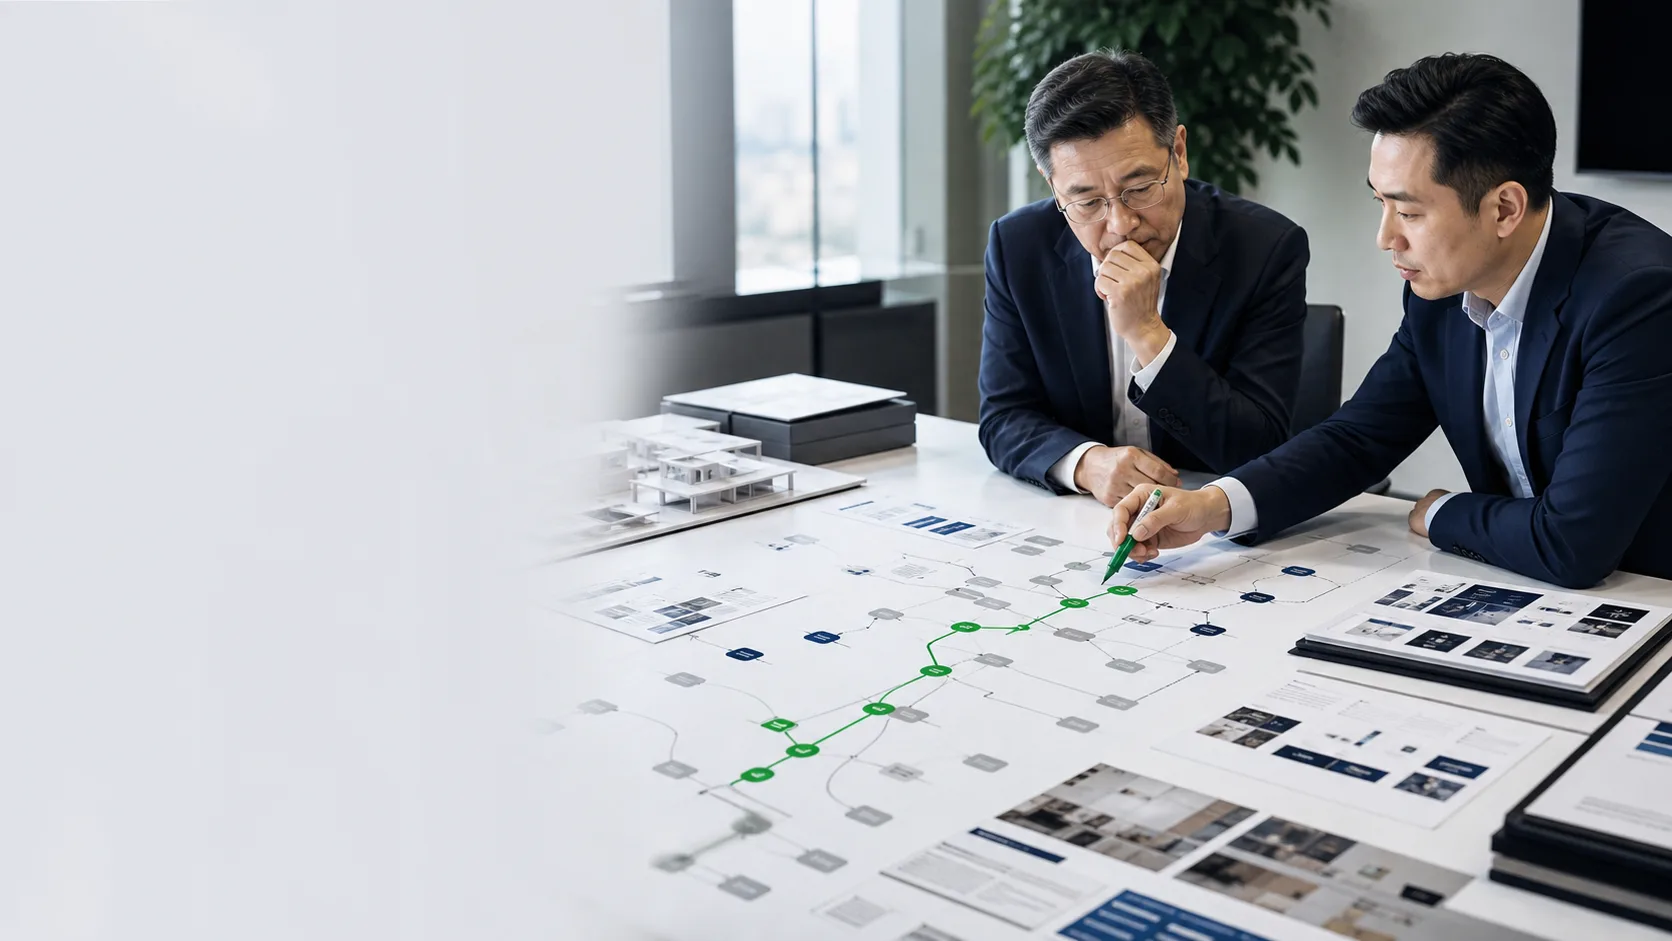
现在企业买GEO服务,有一种特别容易让人不踏实的体验。
月初开会,服务商告诉你这个月会优化豆包、DeepSeek、元宝、千问,补一批内容、调整一批信源、增加品牌推荐率;月底交付的时候,一份几十页PPT摆在桌上,里面有文章数量、平台数量、品牌出现截图、推荐率变化,看起来做了很多。
可老板真正追问一句:
“这一个月到底改了什么,为什么这样改?”
很多项目马上就开始说不清楚。
哪几个问题原来有问题?
AI当时引用了什么?
服务商具体补了什么?
补完以后什么时候测过?
同一个问题前后回答到底发生了什么变化?
如果结果没有变化,下一轮为什么还要继续发同样的内容?
这些问题看起来很像项目管理细节,可悦增长越来越觉得,它们其实决定了一家企业买到的是一套GEO增长服务,还是一个不断生产内容和截图的交付团队。
虎嗅今年对GEO商业化的长篇拆解里,把这件事说得很直接:GEO最容易标准化的部分正在变成监测,团队可以建立固定问题集,在不同模型上反复测试品牌有没有出现、得到什么评价、引用哪些网页,再隔一段时间重新检测变化。文章甚至提出,真正有价值的GEO应该逐渐从黑箱走向“白盒”,让企业知道AI如何描述品牌、信源来自哪里、调整以后到底发生了什么。
所以,如果一家ToB企业问我:
能不能要求GEO服务商每一次优化都留下问题、信源和回测记录?
我的答案很明确:
核心优化动作应该要求。
而且这可能会成为未来企业采购GEO服务时,比“一个月发多少篇”更加重要的验收标准。
第一:企业真正应该防的,不是服务商少发了几篇文章,而是预算花完以后没人知道什么有效
现在GEO市场为什么特别容易回到“内容数量交付”?
因为数量最容易验收。
合同写一个月100篇。
月底确实100篇。
发布20个平台。
后台确实有20个平台链接。
做100个问题监测。
PPT确实有100行数据。
双方都很轻松。
真正麻烦的是效果。
AI回答本身存在变化,同一个问题过几天重新提问,可能换来源;平台更新以后,过去能引用的页面也可能不再出现。Search Engine Land、虎嗅今年对GEO的多轮讨论,都反复提到结果波动和信源漂移的问题。
于是服务商很容易形成一种交付逻辑:
既然结果存在不确定性,那我负责把动作做完。
问题是,企业买GEO,本来就不是为了拥有更多文章。
企业真正需要解决的是:
为什么目标客户问这个问题时没有我?
为什么AI已经知道公司,却描述错了业务?
为什么同行能够进入供应商推荐,我只有行业知识引用?
为什么某个重要案例一直没有成为推荐依据?
如果这些问题一个都没有被解决,文章数量再完整,也只能证明合同动作已经完成。
所以要求优化记录的真正价值,在于企业能够逐渐回答:
哪一类动作,对哪一类问题真正产生过变化。
半年以后,你应该知道:
案例页补充以后,哪些问题开始出现企业。
官网业务定位修改以后,AI的描述有没有逐渐纠正。
某类第三方内容增加以后,哪些模型开始引用。
某些动作连续做三轮没有变化,是不是应该停止。
这些知识本身就是企业的资产。
如果半年GEO做完,企业仍然只知道“服务商说这样做有用”,那整个项目最重要的学习能力其实还在服务商手里。
第二:所谓“每次优化可追踪”,第一步应该从明确问题开始,而不是从“今天发什么内容”开始
很多GEO项目的工作顺序其实倒过来了。
团队每天在问:
今天写什么?
还缺哪个平台?
这个月文章数量够不够?
真正成熟的优化,应该从另一个问题开始:
今天我们准备解决哪个AI认知问题?
假设一家工业设备公司在“复杂存量产线改造供应商推荐”里长期没有出现。
这就是一个明确问题。
进一步看,AI引用的同行材料里,普遍有完整项目案例,而企业官网只有产品参数。
那么第一轮假设可能是:
企业缺少能够证明复杂改造经验的公开案例。
接下来才决定动作:
整理两个存量产线项目。
补项目条件、难点和处理方式。
更新核心服务页。
必要时增加第三方行业内容。
过一段时间重新测试原来那批问题。
你会发现,这整套工作和“本月发30篇”完全是两套逻辑。
前者是实验。
后者是生产。
对于ToB企业,我更愿意把高质量GEO理解成连续的小型增长实验。
一个问题,对应一个判断;一个判断,对应一组动作;一组动作,最后应该能够重新验证。
这样企业才知道自己为什么花钱。
第三:信源记录为什么重要?因为GEO真正优化的越来越不是文章,而是“AI凭什么这样判断”
Bing今年2月推出AI Performance以后,已经可以直接查看网站内容在AI回答里的引用次数、被引用URL以及部分grounding queries,也就是AI在检索时使用过的一部分关键短语。Bing同时明确提醒:引用次数并不代表页面排名、权威性或者它在某一个答案里的重要程度。
Google在2026年6月推出生成式AI搜索表现报告,并在8月31日向全球网站开放以后,也已经可以单独观察网站URL在AI Overviews、AI Mode等生成式搜索里的展示次数、页面、地区、设备和时间变化。
这两个平台的变化说明了一件很重要的事:
GEO正在从“看结果截图”,慢慢走向“研究内容如何参与AI回答”。
这也是为什么企业要记录信源。
比如某个问题里,AI长期引用的是三篇行业媒体和一个竞品案例。
企业想改变结果,就应该知道:
这里到底缺什么?
缺官网核心事实?
缺项目案例?
缺可信第三方验证?
还是企业已经有内容,但页面根本没有被调用?
如果不知道原来的信源结构,所谓优化就很容易变成“再发一批”。
发完以后AI没变化,再发一批。
最后企业真正买到的是一次又一次尝试,却没人知道问题最初在哪里。
所以信源记录不是为了研究所谓“哪个平台权重最高”。
它真正回答的是:
AI今天为什么会形成这个答案。
这个问题一旦能够逐渐看清,企业才有资格谈优化。
第四:回测必须做,但企业也要警惕一种“伪科学式回测”
既然问题和信源都记录了,下一步当然应该重新测试。
但这里又有一个坑。
服务商今天修改一篇文章。
明天测试。
品牌出现了。
然后PPT写:
“经过本次优化,推荐成功。”
这种因果关系其实非常危险。
生成式AI本身就会波动。
平台可能更新。
其他网站可能新增内容。
模型检索结果可能变化。
一次回答发生改变,并不能自动证明刚才那个动作就是唯一原因。
所以企业要求回测,需要的是重复观察,而不是寻找一张最漂亮的截图。
比如:
优化前保存基线。
同样的问题集继续保留。
固定几个主要模型。
重要问题重复测几次。
隔一段时间再次观察。
记录品牌提及、描述、引用和推荐理由有没有持续变化。
如果只是偶尔出现一次,就暂时标记为“观察到变化”。
如果多轮结果都开始发生同方向改变,再提高判断可信度。
这种表达看起来没有“优化后立即生效”那么性感。
但它更接近真实。
Google自己的生成式AI优化指南也明确提醒企业警惕那些宣称掌握“内部指标”或者保证排名成功的第三方工具,因为第三方无法接触Google内部AI和排名系统。
所以悦增长认为:
GEO需要回测,但回测的任务是提高判断可信度,不是制造虚假的因果确定性。
这一点特别重要。
否则“可追踪”最终也可能变成另外一种包装。
第五:真正成熟的优化记录,至少应该留下“问题—假设—信源—动作—回测—结论”六项
企业没有必要要求服务商把每天改一个标点都写成报告。
那会把项目管理做得非常重。
真正需要留下记录的,是那些会影响品牌认知、核心内容、重点信源和目标问题的动作。
我建议至少保留六项。
问题。
这次优化到底要解决什么?
例如:
“制造企业GEO服务商推荐里品牌长期缺席。”
假设。
团队判断原因可能是什么?
例如:
“缺少制造行业真实项目和业务页面支撑。”
这里必须叫假设,不能直接写成事实。
因为AI黑箱环境里,很多原因只能通过实验逐渐验证。
信源。
优化前AI引用谁?
使用哪些网页?
企业自己哪些页面已经出现?
竞品凭什么被推荐?
动作。
到底修改了什么?
官网页面?
案例?
第三方内容?
信息纠错?
页面结构?
回测。
什么时间重新测试?
哪些平台?
使用原来的哪些问题?
结果发生什么变化?
结论。
这一次实验支持了什么判断?
还不能证明什么?
下一轮要不要继续?
如果一家GEO服务商能够长期留下这样的记录,企业半年以后获得的不只是一些推荐结果。
还会得到一套非常重要的“品牌AI认知地图”。
这才开始接近长期价值。
第六:为什么很多服务商不愿意把优化过程讲清楚?
这里其实有一个很现实的商业原因。
一旦GEO变成白盒,很多工作就会暴露真实难度。
有些项目真正有效的动作可能只是:
改了三个页面。
补了两个案例。
更新一个过期信息。
而不是每个月持续生产200篇文章。
对于按文章数量收费的模式,这并不是一个特别舒服的结果。
虎嗅今年2月调查GEO行业乱象时发现,有服务套餐直接包含2000多篇批量生成内容,甚至有服务商在被询问后台系统和算法逻辑时,用“商业机密”来回应。文章把这种模式概括得很直接:大量生产内容、全网铺设,然后赌大模型采样概率。
这也是为什么“可追踪”实际上会改变服务商和企业之间的关系。
以前企业买交付量。
服务商负责执行。
以后企业会越来越需要知道:
这轮为什么做?
如果没效果怎么办?
什么已经证伪?
哪些动作可以停止?
服务商开始从“内容生产方”,变成“问题诊断和实验执行方”。
后者对能力要求明显更高。
可它也更接近ToB企业真正愿意长期付费的价值。
第七:企业要求透明记录,也不能走向另一个极端——要求服务商把所有算法解释清楚
这里必须给“透明”加一个边界。
大模型本身就是复杂系统。
外部团队不可能知道每一个内部权重。
平台更新以后,过去观察到的规律也可能变化。
所以企业不能要求:
“你必须证明为什么这篇文章让豆包推荐了我。”
这种因果在很多时候根本无法严格证明。
真正可以要求的是:
你为什么做这个判断。
依据是什么。
你采取了什么动作。
结果发生了什么。
哪些部分目前仍然不确定。
这已经足够。
Microsoft今年在介绍AI Web的grounding机制时,其实也把GEO描述成研究内容如何参与AI体验的实践,关注内容如何进入答案、引用、推理和最终结果。核心词是“理解”和“观察”,并没有承诺外部网站可以直接控制模型。
所以真正专业的服务商应该敢说:
“这个结论我们目前只有70%的把握。”
“这一次变化可能和我们调整有关,但还需要再观察。”
“这个动作连续三轮没有效果,我们建议停止。”
这种回答听起来没有“我们已经破解算法”那么刺激。
却更值得企业信任。
第八:GEO真正进入长期预算以后,企业买的应该越来越像“可审计的增长过程”
所以回到最开始的问题:
ToB企业找GEO服务商,能不能要求每一次优化都有明确的问题、信源和回测记录?
可以。
而且对于核心问题和重要优化动作,我认为应该成为标准要求。
它真正解决的并不只是项目透明。
更重要的是避免一种非常昂贵的情况:
企业连续做了一年GEO,知道自己发了多少内容,却不知道为什么有效;知道品牌推荐率提高,却不知道哪部分投入值得继续。
真正可持续的GEO,至少应该让企业逐渐积累三种知识。
第一,什么问题最值得企业争夺。
第二,AI现在依据什么认识和判断品牌。
第三,什么类型的动作更可能改变这些结果。
这些东西每积累一个季度,下一轮预算就应该比上一轮更聪明。
如果一年以后,优化方案仍然和第一天一样:
再写一批。
再发一批。
再测一批。
那可能意味着整个项目从来没有真正学习。
所以悦增长对GEO交付越来越看重的一条原则是:
每一次重要优化,都应该留下一个能够被下一次决策使用的结论。
做对了,知道为什么值得继续。
做错了,知道下一轮别再浪费钱。
结果不确定,也把不确定性记录下来。
这样企业留下的才不仅仅是一批AI推荐截图。
它会慢慢拥有一套关于“AI如何认识自己的品牌”的长期知识。
到了那个阶段,服务商有没有继续合作,反而没有那么可怕。
因为真正重要的东西已经沉淀在企业自己这里。
这可能才是GEO从一次外包服务,真正变成品牌增长能力的分界线:预算花出去以后,企业有没有比原来更清楚,AI为什么这样认识自己,以及下一笔钱究竟应该花在哪里。
评论
欢迎留下你的看法,评论会按站点设置审核展示。
0 条评论
还没有评论,来写下第一条吧。
请先登录后即可评论
登录评论已关闭